Una casa non è un mattone
Nell’intelligenza artificiale l’apertura dei pesi non è l’apertura della filiera: la libertà si misura nella capacità di cambiare senza perdere nulla.
Quando sento parlare di intelligenza artificiale nei convegni o sui social, ho spesso l’impressione che ci si divida in tifoserie contrapposte senza fermarsi davvero a guardare cosa c’è sotto il cofano, e devo ammettere che per molto tempo anch’io ho guardato all’etichetta open source come a una specie di porto sicuro. L’idea che qualcuno rilasci gratuitamente un modello linguistico potente, permettendoci di scaricarlo e di farlo girare sui nostri computer invece di bussare sempre ai server di qualche gigante californiano, trasmette un senso immediato di sollievo e di indipendenza. Eppure, più approfondisco come funziona davvero questa tecnologia e più mi rendo conto che la nostra sovranità digitale assomiglia molto alla costruzione di una casa, dove possedere un singolo mattone, per quanto prezioso, non basta affatto a garantirci un tetto sicuro sopra la testa.
Quattro libertà che, nell’IA, non bastano più
Per capire da dove nasce questo equivoco, mi piace fare un passo indietro fino al mondo del software tradizionale, quello che fin dagli anni Ottanta ha costruito l’ossatura invisibile su cui oggi cammina tutta la nostra vita connessa. Quando Richard Stallman diede vita al progetto GNU nel 1983 e formulò le celebri quattro libertà del software libero, o quando nel 1998 nacque l’Open Source Initiative mentre Linux si apprestava a conquistare i server e i supercomputer di mezzo mondo, le regole del gioco erano trasparenti e verificabili. Se avevi accesso al codice sorgente, potevi leggerlo, ripararne i difetti insieme a migliaia di altri sviluppatori, adattarlo alle tue esigenze e soprattutto evitare di restare intrappolato nelle mani di un unico fornitore. È così che sono nati i pilastri silenziosi di internet, dai server web come Apache e Nginx fino ai database che usiamo ogni giorno senza nemmeno accorgercene.
Open-weight non è open source
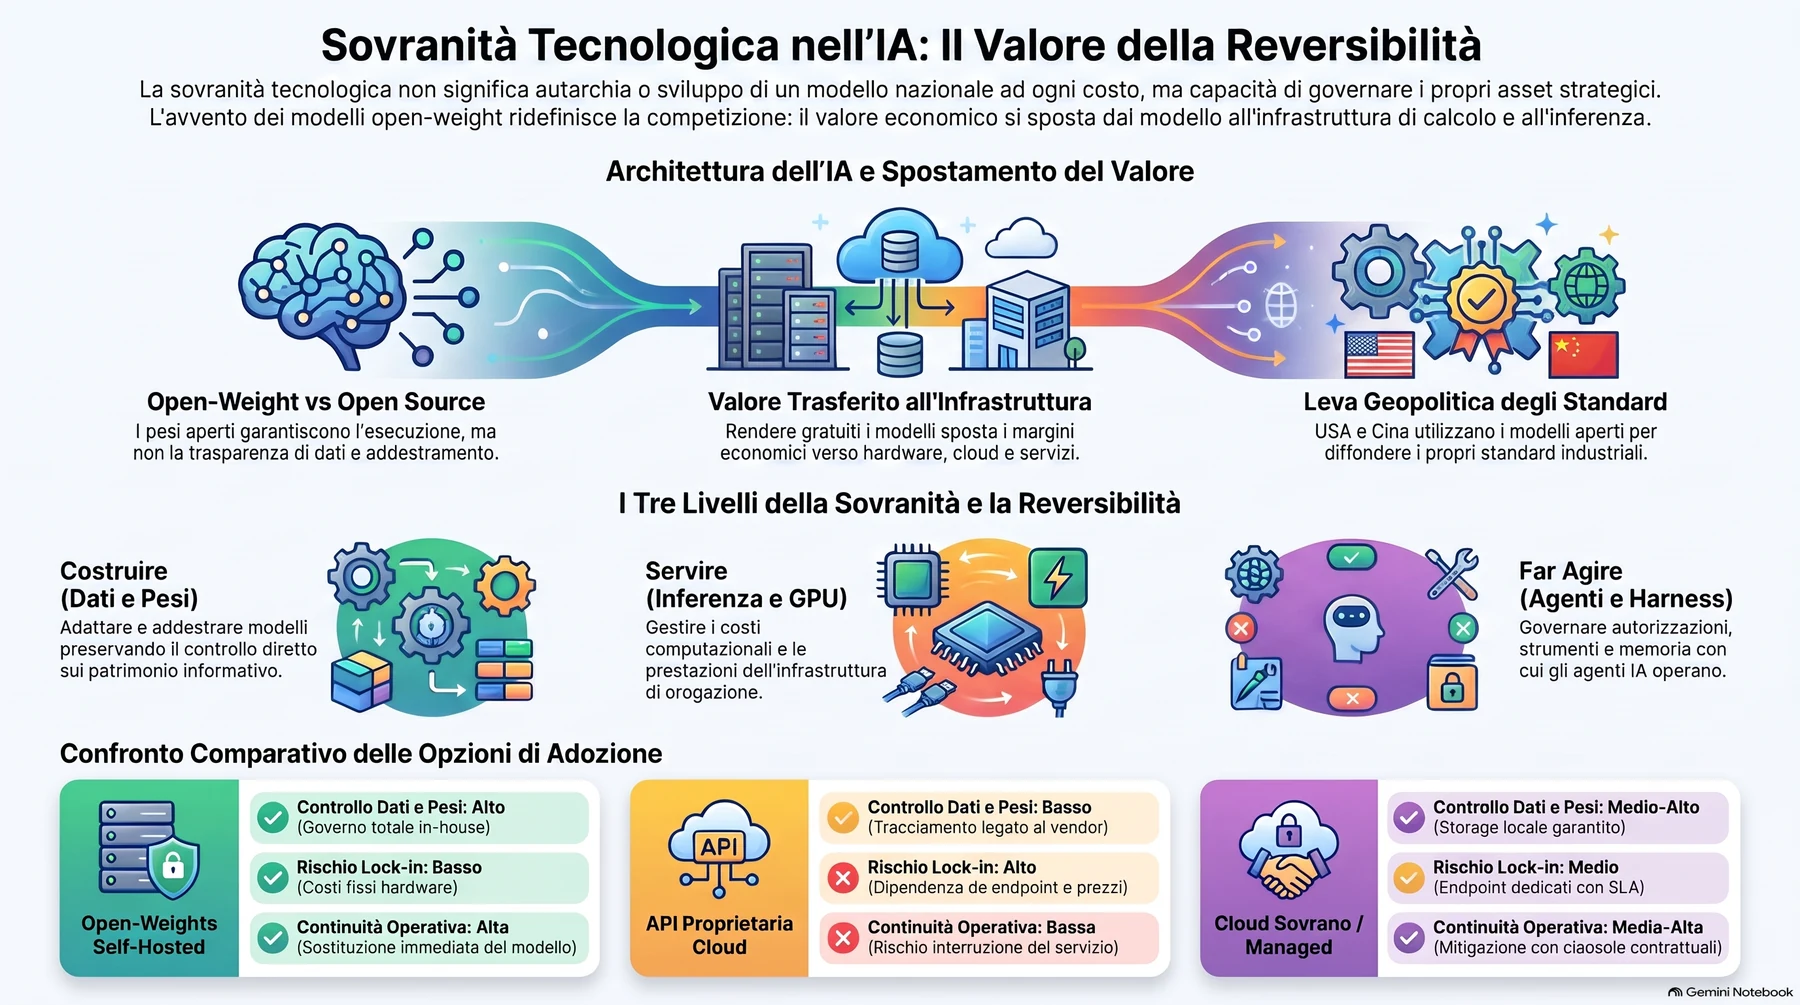
Con l’intelligenza artificiale, però, ho scoperto a mie spese che quel meccanismo così lineare si è incrinato, perché un modello moderno non è fatto soltanto di codice ma è il risultato di dati di addestramento, procedure di ottimizzazione e infrastrutture di calcolo colossali. Quelli che oggi chiamiamo spesso con entusiasmo modelli aperti sono nella maggior parte dei casi modelli open-weight, cioè sistemi di cui ci vengono consegnati i pesi già addestrati — una sorta di cervello pronto all’uso, o se preferite il motore già assemblato di un’automobile. Poter scaricare pesi come quelli di Llama o Mistral è certamente una svolta enorme, perché ci permette di studiare il comportamento del modello, di adattarlo con un ulteriore addestramento ai nostri bisogni e di eseguirlo senza dipendere in tutto e per tutto dall’azienda che lo ha creato. Ma se ci fermiamo un attimo a riflettere, avere soltanto i pesi senza conoscere i dati e il codice con cui sono stati generati è un po’ come ritrovarsi sul tavolo una torta già pronta senza possederne la ricetta, e persino quando si provasse a mettere insieme ricetta e ingredienti, ci si accorgerebbe subito che per addestrare o servire certi sistemi su larga scala serve comunque un forno potentissimo fatto di GPU e data center. Non è un caso che la stessa Open Source Initiative, quando nel 2024 ha provato a definire cosa sia davvero un’IA open source, abbia acceso un dibattito vivace proprio sul nodo della trasparenza dei dati di addestramento.
Chi ci guadagna davvero
Ed è qui che entra in gioco il lato umano ed economico di tutta questa vicenda, quello che spesso rimane nascosto dietro gli slogan sull’etica o sulla sicurezza. Pensiamo alla parabola di OpenAI, nata nel 2015 come organizzazione no-profit con la promessa di condividere la ricerca per evitare monopoli privati sull’intelligenza, e poi trasformatasi gradualmente fino alla chiusura di GPT-4 nel 2023 tra esigenze di sicurezza e costi di addestramento fuori scala.
Da un lato capisco le preoccupazioni reali di chi teme usi pericolosi o di chi investe capitali enormi, ma dall’altro trovo molto lucida la critica di Yann LeCun quando ricorda che la sicurezza di un sistema chiuso che nessuno può ispezionare resta una semplice promessa sulla parola, mentre il prezzo del lock-in e della centralizzazione del potere ricade interamente sulle spalle di chi quei sistemi li usa.
La verità, se guardiamo senza ingenuità a ciò che fanno i grandi attori globali, è che l’apertura è diventata una leva industriale e geopolitica straordinariamente raffinata, capace di spostare il valore economico invece di distruggerlo. Meta ha distribuito apertamente i pesi di Llama non per pura filantropia, ma seguendo la vecchia lezione di Android: rendere gratuito il componente su cui i concorrenti costruiscono la loro rendita, così da consolidare il proprio standard e spostare il guadagno su piattaforme, servizi e pubblicità.
Dall’altra parte del mondo, la Cina ha giocato una carta analoga con iniziative come DeepSeek e la famiglia Qwen di Alibaba, dimostrando di poter raggiungere prestazioni ai vertici a costi competitivi e usando i modelli aperti per costruire soft power tecnologico e ancorare gli sviluppatori globali ai propri ecosistemi. E infine c’è l’esempio forse più illuminante di tutti, quello di NVIDIA con la famiglia Nemotron: il modello viene rilasciato gratuitamente con licenze permissive proprio perché il suo vero business è vendere il silicio, le GPU e l’ecosistema software CUDA che servono a farlo girare al meglio. Come si potrebbe riassumere con una battuta amara ma realistica, il modello è gratis, mentre il motore che lo fa funzionare lo vendono loro.
Che cosa significa sovranità, per noi
Se l’apertura del solo modello finisce per trasferire il valore economico verso chi possiede i chip, i grandi servizi cloud come AWS, Google Cloud o Azure e gli strumenti di esecuzione, allora cosa significa davvero per noi europei e italiani parlare di sovranità digitale senza cadere nell’illusione dell’autosufficienza o nella retorica sterile?
Prima di tutto, significa fare pace con l’idea che la sovranità non è autarchia, perché nessuno pretende che l’Italia o l’Europa producano da sole ogni singolo bullone o microchip della filiera globale. Allo stesso modo, ho capito che la sovranità non può ridursi a tenere i dati chiusi su un server nazionale se poi il software che li elabora è una scatola nera impossibile da ispezionare o sostituire, perché quella sarebbe soltanto una sovranità decorativa, né basta appiccicare una bandierina o un nome nazionale a un modello linguistico per sentirsi al sicuro.
La sovranità si gioca piuttosto su tre livelli concreti — costruire, servire e far agire — ed è soprattutto nei secondi due, cioè nei costi e nelle infrastrutture di inferenza e nel controllo degli agenti che accedono ai nostri documenti e alle nostre decisioni quotidiane, che rischiamo di perdere autonomia senza nemmeno accorgercene. Del resto, le cronache recenti ci hanno già mostrato quanto sia fragile affidarsi senza paracadute a decisioni prese altrove, tra le limitazioni europee imposte da Meta su alcuni modelli multimodali di Llama 3.2 nel 2024, i blocchi temporanei statunitensi su Anthropic nel 2026 e le proposte di controllo cinesi sulle esportazioni nell’ottobre 2026.
La parola che conta: reversibilità
Alla fine di questo percorso, il concetto che mi rimane addosso come una bussola umana e concreta, prima ancora che tecnica, è una parola semplice ma potentissima: reversibilità. La nostra libertà tecnologica non si misura contando quanti modelli abbiamo addestrato o quanti miliardi abbiamo speso in un singolo cluster, ma verificando se un’azienda, un ospedale o una pubblica amministrazione possano cambiare domani modello, fornitore o infrastruttura senza perdere i propri dati, le proprie competenze, la propria memoria operativa e senza pagare un prezzo insostenibile. Non essere prigionieri di una scelta fatta ieri è ciò che trasforma l’open source da moda passeggera a vera autonomia.
L’AI europea alla prova dei fatti: dal caso Polarise alla sovranità dell’intero stack
Il dibattito sull’intelligenza artificiale in Europa si sta spostando da una contrapposizione puramente teorica a una scelta strategica tra prestazioni massime e controllo tecnologico. Da una parte si trovano i modelli di frontiera proprietari sviluppati da aziende statunitensi come OpenAI, Anthropic o Google: sistemi estremamente potenti, aggiornati e sostenuti da investimenti da miliardi di euro e infrastrutture gigantesche.
Essi funzionano però come una «Ferrari chiusa» che è possibile guidare, ma di cui non si può aprire, modificare o riparare il motore. Dall’altra parte emergono i modelli open-weight, paragonabili a un’automobile di cui viene reso disponibile anche il progetto del motore, permettendo alle organizzazioni di studiarlo, adattarlo alle proprie esigenze ed eseguirlo su infrastrutture controllate.
La concreta applicazione di questa seconda strada passa oggi meno dalla creazione di un nuovo modello capace di sfidare frontalmente i giganti americani e più dalla capacità di offrire servizi AI alle imprese su infrastrutture europee. È ciò che emerge dall’annuncio della società tedesca Polarise, che durante l’evento NVIDIA GTC Berlin ha presentato Polarise AI Cloud, una piattaforma progettata per coprire l’intera catena tecnologica, dai data center fino alle applicazioni aziendali.
Gli eventi sul campo: l’architettura Polarise e il caso italiano Increso
La proposta di Polarise mostra come la ricerca di autonomia rispetto ai grandi hyperscaler stia assumendo una forma commerciale precisa. L’offerta si articola in due servizi principali:
- Polarise Rise (già disponibile): un assistente AI rivolto ai dipendenti delle aziende per attività di scrittura, analisi e ricerca in ambienti collaborativi.
- Polarise Drive (in fase di distribuzione controllata): un servizio che consente agli sviluppatori di integrare modelli open-weight — tra cui GLM 5.3, Kimi K3 e NVIDIA Nemotron — tramite API a consumo basato sui token, senza gestire direttamente l’infrastruttura di calcolo. La compatibilità dichiarata con l’SDK di OpenAI è inoltre pensata per ridurre le modifiche tecniche necessarie a migrare applicazioni già esistenti.
Sul piano fisico e industriale, Polarise gestisce infrastrutture in Germania e Norvegia e ha partecipato insieme a Deutsche Telekom e NVIDIA alla costruzione dell’Industrial AI Cloud di Monaco. Adottando moduli chiamati AI Pods per riutilizzare edifici già dotati di connessioni elettriche e autorizzazioni, l’azienda indica di aver portato il polo di Monaco dalla concezione all’operatività in sei mesi.
Ancora più significativo è il passaggio dall’infrastruttura ai processi aziendali reali, testimoniato dal caso della società italiana Increso. Specializzata nella customer experience e tra i primi clienti di Polarise Drive, Increso utilizza modelli NVIDIA Nemotron eseguiti sull’infrastruttura europea di Polarise per alimentare gli agenti AI della propria piattaforma Inxide, servendo oltre 10.000 clienti finali al giorno.
L’esecuzione di modelli a pesi aperti su data center europei esce così dal perimetro teorico per diventare uno strumento operativo in ambiti come l’assistenza clienti, l’automazione documentale, i servizi professionali e le applicazioni industriali verticali.
La teoria dietro i pesi: perché l’open-weight è un’«apertura parziale»
Per comprendere la reale portata di iniziative come quella di Polarise, è necessario evitare di confondere i modelli open-weight con una piena «AI aperta», poiché i pesi costituiscono soltanto uno strato della filiera.
Mentre un modello chiuso fornisce esclusivamente il servizio finale e l’open source completo consegna «motore, progetto, officina e istruzioni di montaggio», un modello open-weight mette a disposizione soltanto il motore. Non a caso, diversi ricercatori europei lo considerano una forma di «apertura parziale».
Sul piano teorico, una reale sovranità tecnologica richiederebbe il controllo di almeno cinque elementi lungo la catena del valore:
- L’esecuzione su server controllati: la possibilità di ospitare e far girare i pesi del modello sulle proprie infrastrutture.
- I dati di addestramento: la conoscenza delle fonti, delle lingue e dei possibili bias culturali su cui il modello è stato istruito; se i dataset restano segreti, non è possibile risalire all’origine delle sue conoscenze.
- Il codice di addestramento: la trasparenza su come il sistema è stato costruito, sugli algoritmi adottati e sui filtri applicati.
- L’infrastruttura hardware: la disponibilità di GPU, chip AI e reti ad alte prestazioni, un terreno su cui l’Europa resta tuttora fortemente dipendente da NVIDIA e da produttori extraeuropei.
- La capacità di riaddestramento: senza adeguata potenza di calcolo, disporre dei pesi non elimina la dipendenza da chi possiede i supercomputer.
Da questa scomposizione emerge il paradosso europeo: anche qualora il continente sviluppasse il miglior modello open-weight al mondo, resterebbe legato agli Stati Uniti se continuasse a fare affidamento su GPU NVIDIA, servizi cloud americani e dataset provenienti da piattaforme statunitensi.
Il caso Polarise riflette con chiarezza questa tensione: la piattaforma impiega infatti sistemi NVIDIA Blackwell e dipende dunque da una filiera hardware internazionale, ma introduce una distinzione rilevante tra la dipendenza dai produttori di chip e la dipendenza commerciale e operativa dagli hyperscaler proprietari. È per questa ragione che l’attenzione degli osservatori si sta spostando dal singolo modello alla sovranità dell’intero stack AI — che comprende dati, modelli, software, hardware, cloud ed energia.
Vantaggi strategici, contendibilità e nuovi rischi di lock-in
Pur non garantendo l’autosufficienza assoluta, la combinazione tra modelli open-weight e infrastrutture europee risponde a quattro obiettivi strategici prioritari:
- Minore dipendenza dagli USA: consente a imprese ed enti pubblici di sottrarsi a decisioni unilaterali su prezzi, disponibilità, regole d’uso e politiche commerciali dei grandi fornitori statunitensi.
- Controllo dei dati e conformità: permette a settori sensibili come sanità, pubblica amministrazione, difesa e ricerca di elaborare le informazioni su server europei senza inviarle continuamente all’esterno.
- Riduzione dei costi d’innovazione: abilita startup, università e PMI a studiare, modificare e costruire prodotti derivati senza ripartire da zero né pagare licenze onerose, replicando l’impatto storico di Linux nel software.
- Maggiore trasparenza: a differenza dei sistemi chiusi in cui si osservano soltanto input e output, i modelli a pesi aperti possono essere analizzati per verificarne sicurezza e bias, rispondendo alle esigenze della regolamentazione europea.
Come evidenziato dal collegamento con il paper di Rivista.AI “Open Source, il potere di scegliere”, l’apertura dei pesi favorisce la comparsa di operatori intermedi che offrono servizi alle imprese senza dover addestrare un modello fondamentale né limitarsi a rivendere le API dei grandi laboratori americani. Separare la scelta del modello da quella dell’infrastruttura e del servizio applicativo rende più contendibile una parte della catena del valore e rafforza il potere contrattuale delle aziende clienti.
Restano tuttavia aperte precise cautele operative ed economiche:
- Il lock-in si sposta ma non svanisce: le imprese possono comunque restare vincolate alle API, agli strumenti di orchestrazione, alle integrazioni e ai servizi gestiti del nuovo fornitore.
- La localizzazione non equivale automaticamente alla sovranità: ospitare i data center in Europa è un passo importante, ma l’effettiva autonomia e la protezione dai rischi giurisdizionali vanno verificate analizzando struttura societaria, licenze dei modelli, contratti con i fornitori, modalità di accesso ai dati e reali costi di migrazione.
- La competitività va misurata sul campo: la convenienza rispetto agli hyperscaler richiede confronti omogenei su costo per operazione, latenza, affidabilità, prestazioni e livelli di servizio.
Verso un realismo tecnologico europeo
L’esperienza di Polarise e di Increso non dimostra che l’Europa abbia già risolto il nodo della propria dipendenza tecnologica, ma prova che sul mercato sta diventando praticabile un’alternativa concreta.
Poiché i modelli di frontiera continuano a offrire le prestazioni più elevate nei compiti complessi e non possono essere semplicemente ignorati, la linea strategica che emerge dall’incontro tra teoria e pratica è di natura ibrida: impiegare i modelli di frontiera quando risultano necessari, ma costruire parallelamente un ecosistema europeo basato su infrastrutture controllabili e modelli open-weight per tutelare indipendenza, continuità operativa e libertà di scelta.
La sfida è tenere insieme i pezzi
La sfida vera, adesso, sta tutta nella nostra capacità di tenere insieme questi pezzi evitando di disperderci in mille rivoli non compatibili tra loro. Perché l’open source, proprio come una casa ben progettata, ci offre finalmente il potere di scegliere chi vogliamo essere nell’era dell’intelligenza artificiale: semplici inquilini in affitto sulle piattaforme di qualcun altro, oppure costruttori consapevoli di un ecosistema in cui tecnologia, lavoro e competenze restano davvero nelle nostre mani.
Domande frequenti
Cinque domande essenziali di reversibilità tecnologica, da verificare prima di adottare un nuovo strumento di intelligenza artificiale nei propri processi di lavoro.
Qual è il livello reale di apertura del modello e cosa permette la sua licenza?
Occorre distinguere tra un sistema davvero open source — con accesso a codice, componenti e informazioni sui dati di addestramento — e un modello open-weight, che rende disponibili soltanto i parametri appresi. L’etichetta open-weight non garantisce l’assenza di restrizioni contrattuali: le condizioni d’uso possono variare persino tra versioni diverse della stessa famiglia di modelli, ponendo limiti su utilizzo commerciale, redistribuzione o obblighi per chi li adotta.
I nostri dati e la memoria operativa restano portatili e sotto controllo?
La sovranità si perde quando i dati devono uscire da un perimetro controllabile per alimentare servizi remoti soggetti a termini di tracciamento o giurisdizioni esterne. Prima di scegliere una piattaforma, bisogna assicurarsi di poter esportare dati, applicazioni e patrimonio informativo senza perderli o dover ripartire da zero in caso di cambio fornitore.
Possiamo cambiare infrastruttura di calcolo e prevedere i costi di inferenza?
Anche un modello aperto può creare nuove dipendenze se resta vincolato a un’unica API proprietaria, a un solo cloud provider o a uno stack hardware-software con alti costi di sostituzione. È decisivo sapere su quali GPU e runtime gira il sistema, con quale facilità può migrare altrove e se i costi di inferenza siano trasparenti anziché esposti a variazioni tariffarie unilaterali.
Controlliamo gli agenti, le autorizzazioni e i protocolli di integrazione?
Quando gli strumenti di intelligenza artificiale agiscono in autonomia — leggendo documenti, interrogando database o usando API — controllare il solo modello non basta più. Bisogna verificare che memoria, orchestrazione, permessi di accesso e protocolli (come MCP) adottino architetture interoperabili e verificabili, evitando che l’eventuale sostituzione della piattaforma costringa a riscrivere l’intero sistema.
Disponiamo delle competenze e della sostenibilità economica per sostituire il fornitore?
Poter scaricare un modello serve a poco senza le competenze interne necessarie per adattarlo, integrarlo, valutarne le prestazioni e gestirne la manutenzione nel tempo. Poiché l’accesso a modelli e servizi può cambiare improvvisamente per scelte commerciali, blocchi o restrizioni geopolitiche, la vera prova di continuità operativa è poter cambiare strada senza sostenere costi di migrazione proibitivi.
Utilizzare questa griglia prima di firmare un contratto o avviare un progetto permette di trasformare una scelta tecnologica da potenziale vincolo permanente a un’interdipendenza governabile, verificabile nei costi, nelle architetture e nelle clausole contrattuali.
Le considerazioni di questo articolo nascono dalla lettura del Research Paper «Open Source, il potere di scegliere» di Rivista.AI — serie Sovranità tecnologica, ottobre 2026 — realizzato con TechVisory a partire dalle riflessioni di Franco Bernabè. Il paper completo.


Da informatico a cercatore di senso
Unisciti al mio mondo di conoscenza e iscriviti al mio canale WhatsApp.
Sarai parte di una comunità appassionata, sempre aggiornata con i miei pensieri e le mie idee più emozionanti.
Non perderti l’opportunità di essere ispirato ogni giorno, iscriviti ora e condividi questa straordinaria avventura con me!
Nota di trasparenza sull’uso dell’AI nel blog
In questo spazio digitale, dedicato alla comprensione critica dell’innovazione tecnologica, desidero condividere con chiarezza due aspetti importanti del lavoro che porto avanti.
Immagini generate con l’AI
La quasi totalità delle immagini presenti nel blog è generata tramite strumenti di intelligenza artificiale. Le utilizzo sia come supporto visivo sia come modo per sperimentare nuove forme di comunicazione creativa, coerenti con i temi trattati.
Un blog nato dalla scrittura… e trasformato dalla velocità dell’AI
Scrivere è sempre stata una mia passione. Dopo anni di appunti, riflessioni e sperimentazioni, tre anni fa è nato questo blog. Fin da subito, però, ho dovuto confrontarmi con una sfida evidente: l’incredibile accelerazione dell’evoluzione scientifica legata all’intelligenza artificiale rende complesso mantenere aggiornato un progetto di divulgazione che ambisce alla qualità e alla precisione.
Per questo, in coerenza con la mia missione di promuovere consapevolezza, oggi più che mai un elemento vitale, ho scelto di farmi affiancare da piattaforme di AI in molte fasi del lavoro editoriale. In particolare, l’AI mi supporta in:
- ricerca e verifica preliminare delle notizie
- organizzazione e strutturazione degli articoli
- creazione di sezioni HTML per FAQ e link alle fonti
- ideazione di infografiche
- esplorazione di titoli efficaci e pertinenti
L’obiettivo non è delegare il pensiero, ma amplificare la capacità di analisi e di sintesi, così da offrire contenuti sempre più chiari, accurati e utili.

